
Problem
Zmiany schematu psują produkcję, gdy są traktowane jako jeden krok. Bezpieczna ewolucja to sekwencja: przygotowanie, przejście, weryfikacja i dopiero usunięcie starej ścieżki.
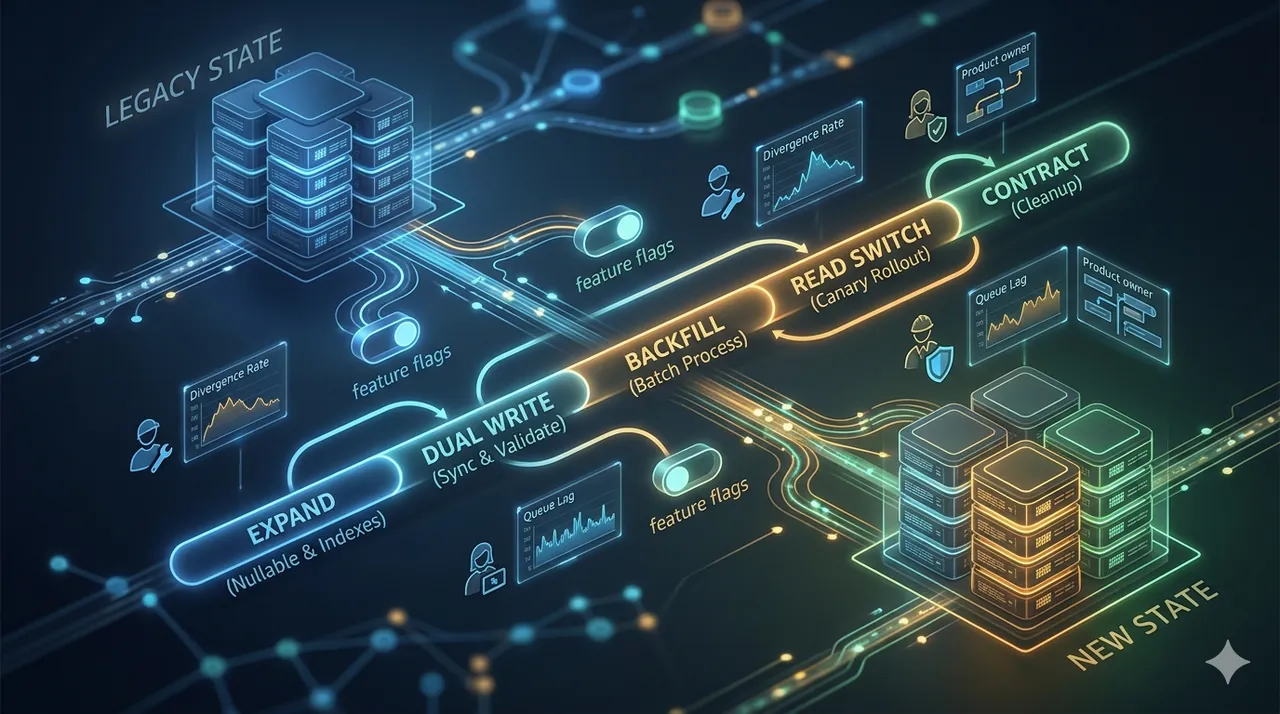
Bezpieczna Sekwencja Rolloutu
- Expand: dodanie nullable kolumn/tabel i kompatybilnych indeksów.
- Dual write: zapis do starego i nowego modelu danych za feature flagą.
- Backfill: idempotentne batche z obserwowalnością opóźnień i błędów.
- Read switch: przełączenie odczytu na nowy model z monitoringiem canary.
- Contract: usunięcie starych pól po zakończonym oknie stabilizacji.
Wymagania Operacyjne
- Każda migracja powinna być odwracalna albo bezpiecznie pauzowalna.
- Backfill w tle potrzebuje ograniczonego batch size i polityki retry.
- Metryki muszą pokazywać split read/write i rozjazd danych.
- Notatki release powinny opisywać kolejność zależności między usługami.
Trade-Offy
Migracja bez downtime trwa dłużej niż bezpośrednia zamiana, ale zamienia jedno duże ryzyko na serię mniejszych, kontrolowanych decyzji.
Sygnały Awarii
Wstrzymaj rollout, gdy rozjazd między starym i nowym odczytem przekracza próg, rośnie latencja kolejek albo błędy skupiają się wokół przełączonych endpointów.
Praktyka Zespołowa
Wprowadź rolę “migration owner” dla każdego release. Jasna odpowiedzialność za telemetrię rolloutu skraca czas reakcji na odchylenia.
Podsumowanie
Zero-downtime to głównie dyscyplina release. Rails dobrze to wspiera, gdy zmiana schematu jest traktowana jak proces delivery produktu, a nie jednorazowe utrzymanie bazy.
Praktyczna Checklista Przed Migracją
- Zdefiniuj okno kompatybilności wstecznej.
- Potwierdź odpowiedzialność za zapis/odczyt w okresie dual-write.
- Przygotuj dashboard rozjazdu danych i opóźnień kolejek.
- Ustal jawne warunki zatrzymania rolloutu i właściciela decyzji.
Przykładowa Oś Wdrożenia
Release A: rozszerzenie schematu i dark path w kodzie.
Release B: uruchomienie dual-write i monitorowanego backfill.
Release C: przełączenie odczytu z walidacją canary.
Release D: usunięcie starej ścieżki po oknie stabilizacji.
Błędy, Których Unikać
- Backfill bez limitów w godzinach szczytu.
- Przełączanie odczytu bez metryk rozjazdu w czasie rzeczywistym.
- Usuwanie starych kolumn przed zamknięciem okna rollbacku.
- Pomijanie kolejności zależności między usługami.
Wzorzec Komunikacji Zespołu
Publikuj krótkie briefingi migracyjne do zespołów produktu i supportu. Zero-downtime to praca techniczna, ale ryzyko incydentu wpływa na całą organizację.
Pełny Playbook Migracji
Faza planowania
Zacznij od mapy wszystkich ścieżek kodu dotykających schematu: zapis, odczyt, joby asynchroniczne, eksporty i integracje zewnętrzne. Najwięcej awarii wynika z pomijania konsumentów poza warstwą web.
Checklista gotowości
- Feature flagi gotowe dla dual-write i read switch.
- Idempotencja joba backfill potwierdzona.
- Dashboard monitoringu opublikowany przed deploymentem.
- Właściciel rollbacku i ścieżka eskalacji ustalone.
- Product/support poinformowane o harmonogramie.
Strategia backfill w praktyce
Stosuj ograniczone batch size i krótkie przerwy, aby zmniejszyć presję locków. Zapisuj markery postępu, aby bezpiecznie wznawiać proces po błędzie. Loguj metryki per batch i pokazuj je na dashboardzie operacyjnym.
Walidacja spójności danych
W oknie dual-write sprawdzaj zgodność starej i nowej reprezentacji: liczności, próbki diffów i agregaty krytyczne. W systemach wysokiego ryzyka uruchamiaj automatyczne parity checki jako część deployment workflow.
Wykonanie cutover
Przełączaj odczyt stopniowo:
- tylko ruch wewnętrzny,
- segment tenantów niskiego ryzyka,
- pełny rollout z aktywnym monitoringiem.
Zachowaj stary zapis na krótki okres pewności po przełączeniu odczytu, a wyłącz go dopiero po stabilnych metrykach.
Plan reakcji incydentowej
Zdefiniuj szybkie akcje rollbacku przed cutover:
- cofnięcie flagi odczytu do ścieżki legacy,
- pauza workerów backfill,
- zamrożenie migracji cleanup.
To ogranicza chaos przy nieoczekiwanym pogorszeniu metryk.
Metryki per faza
- Expand: czas migracji i lock wait.
- Dual write: latencja zapisu i rozjazd danych.
- Backfill: throughput, retry ratio, lag.
- Read switch: error rate, p95/p99, liczba mismatch.
- Contract: częstotliwość incydentów po cleanup.
Rekomendacja końcowa
Ewolucja schematu bez downtime to dyscyplina delivery wielu zespołów. Traktuj ją jako orkiestrację z checkpointami, a nie pojedyncze zadanie bazodanowe.
Checklista per Rola
Engineering lead
- zatwierdza strategię migracji i granice rollbacku,
- podpisuje gotowość produkcyjną przed cutover.
Backend engineer
- wdraża bezpieczny dual-write/read-switch,
- dodaje parity check i logowanie.
SRE/operations
- waliduje progi alertów i runbooki,
- monitoruje locki i saturację podczas rolloutu.
Product manager
- ustawia okna release względem checkpointów ryzyka,
- komunikuje przewidywany envelope ryzyka.
Support lead
- przygotowuje szablony komunikatów customer-facing.
Realistyczny Harmonogram Dla Systemu Średniej Skali
Dzień 1-2: expand schematu i deployment uśpionych ścieżek odczytu.
Dzień 3-5: dual-write dla segmentu wewnętrznego.
Dzień 6-10: monitorowany backfill z dashboardem lag.
Dzień 11-14: canary read-switch dla tenantów niskiego ryzyka.
Dzień 15+: pełny rollout i plan cleanup.
Takie tempo ogranicza presję i poprawia jakość decyzji.
Bramki Decyzyjne Chroniące Przed Incydentem
Bramka A: rozjazd dual-write poniżej progu przez 48h.
Bramka B: error ratio backfill poniżej progu przez N batchy.
Bramka C: canary read-switch ze stabilnym p95/p99 i error-rate.
Bramka D: skuteczny drill rollbacku przed cleanup.
Jeśli któraś bramka zawiedzie, zatrzymaj rollout i napraw przyczynę.
Author
Grzegorz Lisowski