
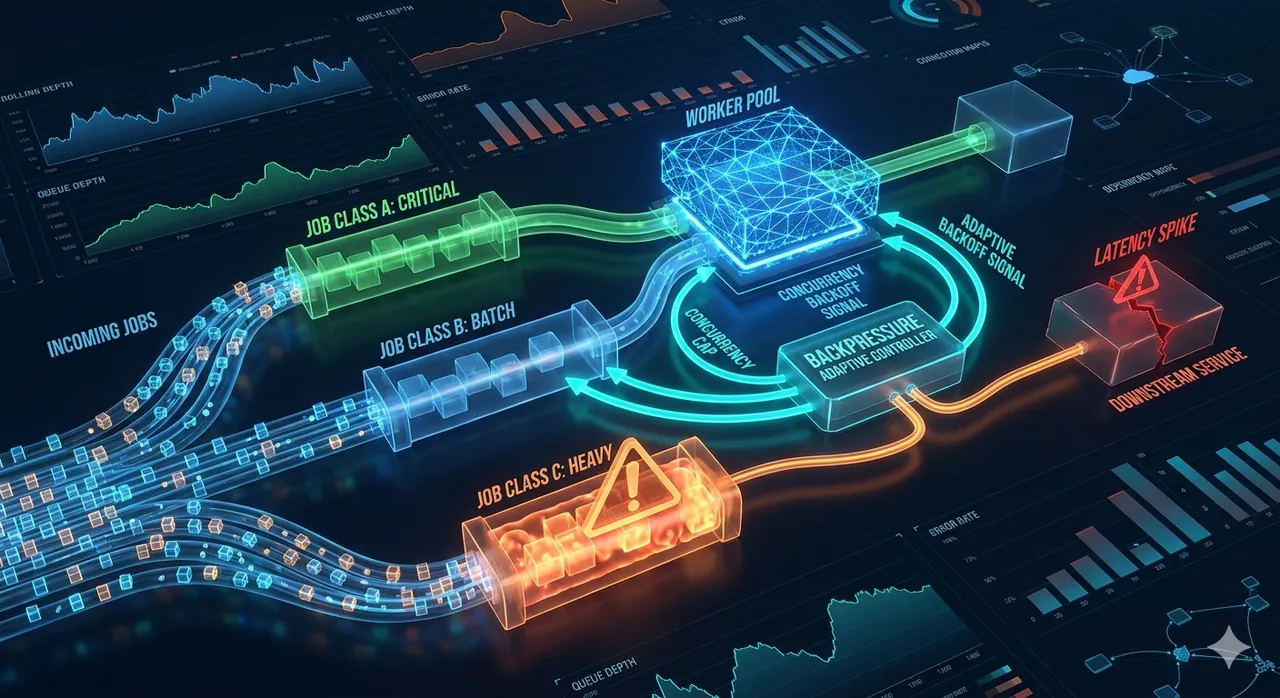
Cel Eksperymentu
Chcieliśmy odpowiedzieć na jedno praktyczne pytanie: która strategia backpressure najlepiej chroni stabilność systemu, gdy kolejki jobów rosną skokowo, a zależności zewnętrzne zwalniają?
Projekt Testu
Symulowaliśmy burst traffic dla worker pooli z mieszanymi profilami kosztu jobów. Porównaliśmy:
- naiwne retry,
- fixed-rate throttling,
- limity współbieżności na poziomie kolejek,
- adaptive backoff sterowany błędami i latencją.
Metryki Oceny
- Latencja kolejki i czas opróżniania.
- Wzmocnienie błędów przez retry.
- Wpływ uboczny na synchroniczne endpointy API.
- Szybkość odzyskania po normalizacji usług zależnych.
Kluczowe Wyniki
- Naiwne retry powodowało retry storm i wydłużało degradację.
- Fixed-rate throttling poprawiał stabilność, ale niedowykorzystywał przepustowość po odbudowie.
- Limity współbieżności zmniejszały blast radius drogich klas jobów.
- Adaptive backoff dawał najlepszy kompromis między ochroną a szybkością odzyskania.
Praktyczny Wzorzec
Najlepiej działa izolacja kolejek wg klas jobów plus progi adaptive backoff. Pozwala to utrzymać przepływ krytycznych zadań i jednocześnie izolować hałaśliwe workloady.
Wskazówki Operacyjne
Backpressure musi iść w parze z obserwowalnością: depth kolejek, wiek retry i latencja zależności powinny być widoczne na dashboardach. Bez tego zespoły łatwo przesterowują throttling.
Podsumowanie
Backpressure to mechanizm niezawodności, nie tylko skalowania. Zespoły, które jawnie modelują zachowanie przy awarii, szybciej wracają do stabilności i ograniczają incydenty kaskadowe.
Blueprint Wdrożeniowy
- Segmentuj kolejki wg krytyczności biznesowej.
- Ustal limity współbieżności per kolejka.
- Powiąż retry policy z klasą błędu (przejściowy vs deterministyczny).
- Dodaj adaptacyjne pauzowanie, gdy latencja zależności przekracza próg.
Dashboard Produkcyjny Minimum
- Depth kolejki per klasa.
- Wiek najstarszego joba.
- Wolumen retry per typ workera.
- Latencja i timeouty usług zależnych.
Fazy Rolloutu
Faza 1: obserwowalność i progi pasywne.
Faza 2: limity wymuszone dla kolejek niekrytycznych.
Faza 3: adaptive backoff z automatycznym zwalnianiem.
Faza 4: cykliczne strojenie na podstawie incydentów i testów obciążeniowych.
Antywzorce
- Jedna globalna polityka retry dla wszystkich klas jobów.
- Nieograniczona współbieżność “szybkich” jobów bez ochrony zależności.
- Triggery backpressure bez widocznej telemetrii dla zespołu.
Rekomendacja Końcowa
Traktuj politykę backpressure jako część przeglądu architektury systemu. Zachowanie kolejek powinno być projektowane pod awarie zanim szczyt ruchu wymusi działania awaryjne.
Szczegóły Setupu Eksperymentu
Profil workloadu
Modelowaliśmy trzy klasy jobów:
- krótkie joby krytyczne (widoczne dla użytkownika),
- joby batch średniego kosztu (synchronizacja danych),
- joby ciężkie (raportowanie/agregacje).
Ruch był podawany burstowo, aby odwzorować kampanie i fale retry.
Model awarii
Symulowaliśmy częściową degradację zależności: wyższą latencję i okresowe timeouty. To bardziej realistyczne niż testy pełnego outage.
Testowane hipotezy
- Naiwne retry maksymalizuje throughput tylko przy zdrowych zależnościach.
- Stały throttling zmniejsza ryzyko incydentu, ale spowalnia odzyskiwanie.
- Adaptive backoff daje lepszą odporność przy wiarygodnych sygnałach.
Szczegółowe obserwacje
- Retry storm był nieliniowy: po przekroczeniu progu wieku kolejki czas odzyskania podwajał się.
- Limity działały najlepiej, gdy były strojone per klasa joba.
- Polityki adaptacyjne zawodziły przy opóźnionej lub zaszumionej telemetrii.
- Zespoły z jawnym ownerem kolejki szybciej przywracały stabilność.
Przewodnik wdrożenia
- Otaguj klasy jobów wg krytyczności i maksymalnego akceptowalnego lag.
- Ustal oddzielne retry policy per klasa.
- Dodaj dynamiczne pauzy/wznowienia wg zdrowia zależności.
- Zabezpiecz kolejki krytyczne rezerwowaną współbieżnością.
- Testuj failover kwartalnie na sztucznych burstach.
Rollback i kontrolki bezpieczeństwa
Zachowaj manualny override wyłączający logikę adaptacyjną przy niestabilnych sygnałach. Automatyzacja pomaga, ale ręczna kontrola chroni przed uszkodzoną telemetrią i dryftem konfiguracji.
Progi startowe
- Pauzuj kolejki niekrytyczne, gdy timeout rate zależności utrzymuje się ponad próg przez N minut.
- Ograniczaj współbieżność krokowo, gdy nachylenie wieku kolejki rośnie ponad baseline.
- Wznawiaj stopniowo po oknie stabilności, nie po pojedynczej próbce.
Governance długoterminowy
Strojenie backpressure powinno być przeglądane po każdym większym incydencie i dużym launchu produktu. Dryft polityki kolejek narasta cicho i szybko bez regularnych przeglądów.
Praktyczny Przewodnik Odtwarzania Eksperymentu
Przygotowanie środowiska
Zbuduj reprezentatywny staging z topologią kolejek zbliżoną do produkcji, realistyczną współbieżnością workerów i syntetycznymi zależnościami, które potrafią wstrzykiwać latencję i timeouty. Uproszczone testy lokalne często ukrywają realny profil awarii.
Model ruchu
Użyj powtarzalnych faz:
- baseline stabilny,
- okno burst 3x baseline,
- stres utrzymany 1.5x baseline,
- kontrolowane odzyskanie.
Sekwencja musi być identyczna dla każdej testowanej strategii.
Pakiet pomiarowy
Zbieraj:
- depth kolejki per klasa w czasie,
- rozkład wieku jobów,
- retry wg kategorii błędu,
- krzywe latencji/timeoutów zależności,
- opóźnienie widoczne dla użytkownika na kluczowych przepływach.
Dzięki temu jakość polityki kolejek łączy się z wynikiem biznesowym.
Perspektywa interpretacji
Oceń strategię w czterech osiach:
- stabilność przy burstach,
- ograniczanie amplifikacji retry,
- szybkość bezpiecznego odzyskania,
- przewidywalność operacyjna dla on-call.
Sam peak throughput nie jest metryką bezpieczeństwa produkcji.
Author
Grzegorz Lisowski