
Punkt Wyjścia
Zespół przejął system Rails legacy z nierównym pokryciem testami, niejasnymi wąskimi gardłami runtime i niską pewnością release. Biznes oczekiwał dalszego rozwoju funkcji mimo nieudokumentowanego ryzyka technicznego.
Cel
Zbudować audyt pierwszego miesiąca, który prowadzi do decyzji, a nie tylko dokumentacji: co stabilizować natychmiast, co odłożyć i co przeprojektować.
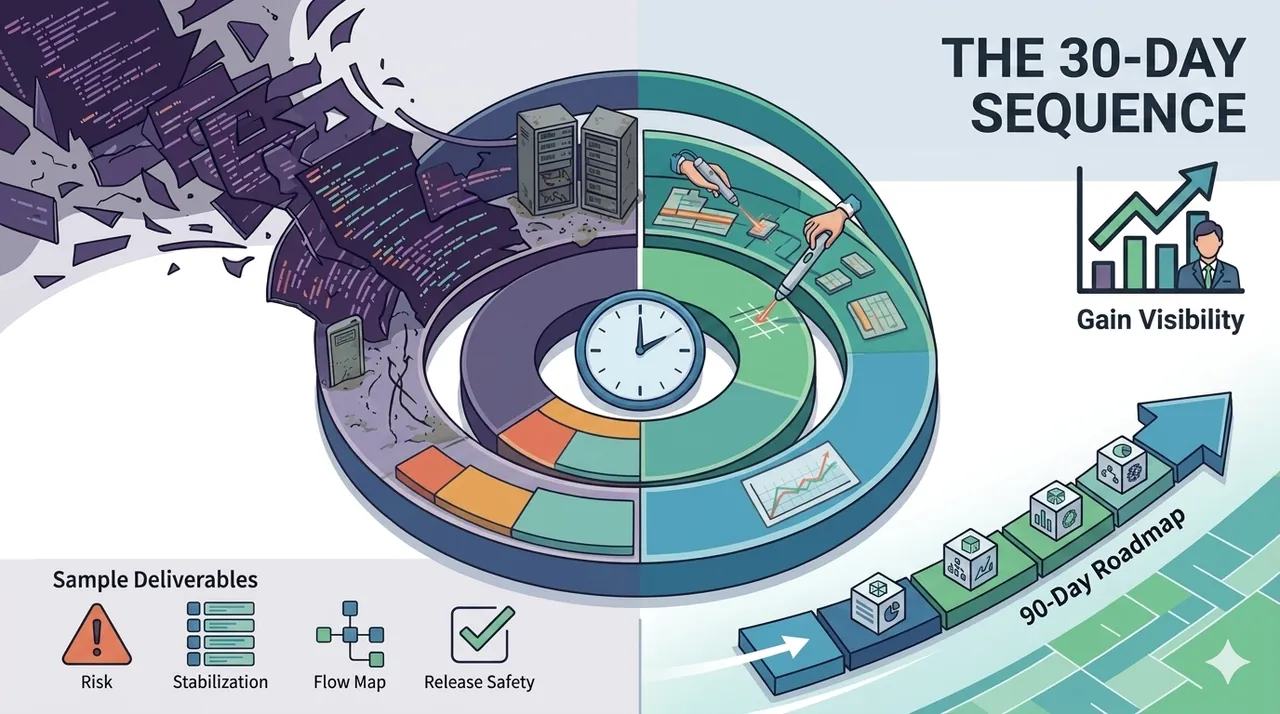
Sekwencja 30 Dni
Tydzień 1 - Mapowanie Systemu
- Identyfikacja krytycznych user journey i przepływów wpływających na przychód.
- Mapowanie zależności integracyjnych i odpowiedzialności operacyjnej.
- Zebranie głównych klas błędów produkcyjnych i outlierów latencji.
Tydzień 2 - Klasyfikacja Ryzyka
- Klasyfikacja ryzyk wg wpływu i odwracalności.
- Rozdzielenie “must-fix przed rozwojem funkcji” od “można monitorować.”
- Ustalenie mierzalnych kryteriów akceptacji dla zadań stabilizacyjnych.
Tydzień 3 - Proby Wykonawcze
- Uruchomienie małych interwencji (query shaping, polityki retry, testy guard).
- Pomiar efektu operacyjnego przed skalowaniem rozwiązania.
- Zamiana udanych prób na powtarzalne wzorce.
Tydzień 4 - Roadmapa Delivery
- Publikacja priorytetyzowanej roadmapy 90-dniowej z właścicielami i checkpointami.
- Dopasowanie sekwencji produktu do ograniczeń ryzyka technicznego.
- Ustalenie rytmu przeglądów i adaptacji roadmapy.
Efekty
Zespół przeszedł od reaktywnego gaszenia pożarów do kontrolowanego planowania delivery. Kluczowa korzyść: lepsza widoczność, co jest ryzykowne, co stabilne i gdzie potrzebna jest inwestycja.
Co Warto Powtórzyć
Audyt powinien być lekki, oparty o metryki i jawnie powiązany z decyzjami produktowymi. Wartość tworzy jakość decyzji, nie objętość raportu.
Przykładowe Artefakty Na Dzień 30
- Rejestr ryzyk posortowany wg wpływu biznesowego i odwracalności.
- Backlog stabilizacji z właścicielami, estymacją i oczekiwanym efektem KPI.
- Mapa zależności z punktami integracji o najwyższym ryzyku.
- Checklista bezpieczeństwa release dla dalszego rozwoju funkcji.
KPI Po Audycie
- Trend częstotliwości i wagi incydentów.
- Change failure rate.
- Lead time dla release o średnim ryzyku.
- Procent kamieni milowych roadmapy dowiezionych w terminie.
Częste Pułapki
- Nadmiar dokumentacji bez przypisania właścicieli i terminów.
- Mieszanie pilnej stabilizacji ze strategicznym refaktorem w jednym backlogu.
- Koncentracja na stylu kodu przy nierozwiązanym ryzyku produkcyjnym.
Praktyczna Wskazówka
Komunikację z zarządem utrzymuj krótką i decyzyjną. Potrzebne są jasne opcje, poziom pewności i konsekwencje opóźnienia.
Rozszerzona Oś Przypadku
Dni 1-3: wejście i framing ryzyka
Zrobiliśmy wywiady z engineeringiem, produktem i supportem, aby opisać problemy językiem operacyjnym, nie wyłącznie technicznym. To szybko pokazało różnicę między ryzykiem postrzeganym a realnym.
Dni 4-7: zbieranie dowodów runtime
Przeanalizowaliśmy logi, historię incydentów i zdarzenia deploymentowe. Kluczowy wniosek: większość awarii pochodziła z granic integracyjnych, a nie z rdzenia logiki domenowej.
Dni 8-12: mapa architektury i odpowiedzialności
Zmapowaliśmy ownerów modułów/usług i znaleźliśmy obszary osierocone bez jasnej odpowiedzialności. Te strefy silnie korelowały z zaległymi defektami i opóźnieniami release.
Dni 13-18: szybkie interwencje stabilizacyjne
Wybraliśmy działania niskiego ryzyka i wysokiego wpływu:
- cleanup ścieżek zapytań na endpointach z najwyższą latencją,
- deterministyczne retry dla niestabilnych integracji,
- poprawa jakości alertów bazowych.
To nie modernizowało całego systemu, ale od razu podniosło pewność release.
Dni 19-24: tłumaczenie ryzyka na roadmapę
Zamiast etykiet “dług techniczny” każde ryzyko opisaliśmy wpływem delivery: blokowane funkcje, ekspozycja na downtime, ograniczenia skalowania. Dzięki temu rozmowa o roadmapie stała się konkretna.
Dni 25-30: pakiet decyzyjny dla leadershipu
Przygotowaliśmy trzy scenariusze:
- minimalna stabilizacja,
- wariant zbalansowany (stabilność + ciągłość rozwoju),
- agresywna modernizacja.
Każdy scenariusz zawierał wynik oczekiwany, zasoby i przedział pewności.
Co zadecydowało o skuteczności
- narracja oparta na dowodach, nie na opiniach,
- jawna odpowiedzialność za każde działanie,
- mierzalne kryteria sukcesu i checkpointy,
- bezpośrednie powiązanie ryzyka technicznego z wpływem produktowym.
Szablon do ponownego użycia
- Zbierz dowody z incydentów i release.
- Klasyfikuj ryzyka wg wpływu biznesowego i odwracalności.
- Uruchamiaj małe próby przed szerokim refaktorem.
- Zamień wyniki na warianty roadmapy scenariuszowej.
- Monitoruj efekty KPI przez 90 dni.
Nota końcowa
Audyt pierwszego miesiąca ma redukować niejednoznaczność, a nie zwiększać objętość dokumentacji. Jeśli jakość decyzji nie rośnie do dnia 30, audyt pozostaje niepełny.
Zestaw Startowy Dla Nowych Zespołów
Artefakty, które warto przygotować przed tygodniem 1:
- mapa interesariuszy i granic odpowiedzialności,
- szablon timeline incydentów,
- rubryka scoringu ryzyka,
- szablon backlogu stabilizacji z polami decyzyjnymi.
Gotowe formaty przyspieszają pracę i eliminują spory o strukturę raportu.
Rytm Decyzyjny, Który Zadziałał
Stosowaliśmy dwa przeglądy ryzyka tygodniowo:
- jeden do walidacji dowodów,
- jeden do zatwierdzenia działań.
Taki podział zmniejsza decyzje emocjonalne i poprawia dyscyplinę wykonania.
Jak Priorytetyzować Stabilizację
Użyj prostego wzoru:
priorytet = wpływ biznesowy x prawdopodobieństwo awarii x współczynnik odwracalności.
Zadania o wysokim wpływie, wysokim prawdopodobieństwie i niskiej odwracalności powinny iść pierwsze.
Wzorzec Komunikacji ze Stakeholderami
Aktualizacje powinny być krótkie:
- co zmieniło się od poprzedniego raportu,
- które ryzyko wzrosło/spadło,
- jaka decyzja jest potrzebna teraz.
Ten format utrzymuje zaufanie i ogranicza zmęczenie komunikacyjne.
Author
Grzegorz Lisowski